
Große Dateien, im Browser verschlüsselt: Wie ein 20-GB-Upload funktioniert, ohne dem Server zu vertrauen
Blockweise Verschlüsselung bei konstantem Arbeitsspeicher, S3-Multipart hinter dem Backend, Integrität pro Block und ein Download, der direkt auf die Festplatte streamt. Große Dateien in Sapherbox.
Ende-zu-Ende-Verschlüsselung lässt sich mit einem 200-KB-PDF leicht vorführen: in den Speicher lesen, verschlüsseln, senden. Schwierig wird es an dem Punkt, an dem eine Datei nicht mehr bequem in einen Browser-Tab passt. Ein forensisches Abbild von 20 GB, eine Videoaussage von 4 GB, ein Datenbankexport: Der Browser kann weder den Klartext noch das Chiffrat vollständig im Arbeitsspeicher behalten, und er darf auch keines von beidem an den Server abgeben, der die Arbeit übernehmen könnte. Der Server hat keinen Schlüssel und darf nie einen bekommen.
Dieser Artikel beschreibt, wie Sapherbox große Dateien bewegt. Er geht tiefer ins Detail als die meisten unserer Beiträge. Die Fragen, die uns zu großen Dateien erreichen, sind detailliert, und die Entwurfsentscheidungen sind, einmal aufgeschrieben, gar nicht kompliziert. Alles, was folgt, beschreibt den heutigen Stand von Browser, Sync-Client und Backend.
Ein Format für jede Datei
Jede Datei, die Sapherbox speichert, ob 4 KB oder 40 GB, hat dieselbe Form: eine Folge verschlüsselter Blöcke. Der Klartext wird in Blöcke von 10 MB zerlegt. Jeder Block wird für sich mit AES-256-GCM unter dem Schlüssel der Datei verschlüsselt und besteht danach aus einer 12 Byte langen Nonce, dem Chiffrat und dessen 16 Byte langem Authentifizierungs-Tag. Eine kleine Datei ist schlicht ein einziger Block.
Die Nonce jedes Blocks wird aus einer zufälligen Basis-Nonce der Datei abgeleitet, indem der Blockindex in die letzten vier Bytes der Basis-Nonce eingerechnet wird. So hat jeder Block eine eigene Nonce, ohne dass der Client eine Liste davon speichern müsste. Der Blockindex geht außerdem als zusätzliche authentifizierte Daten (Associated Data, AAD) in die Verschlüsselung ein. Auf dieses zweite Detail kommt es an: Ein Block lässt sich nicht an eine andere Stelle verschieben, verdoppeln oder weglassen, ohne dass die Prüfung auf dem Rückweg fehlschlägt. Ein Objektspeicher, oder wer darauf schreiben kann, kann eine Datei beschädigen. Unbemerkt umsortieren kann es sie nicht.
Der letzte Block wird mit Zufallsbytes auf eine Zweierpotenz aufgefüllt, mindestens 4 KB, damit die gespeicherte Größe eines kleinen Dokuments nur eine Größenklasse verrät und keine exakte Bytezahl. Die wahre Länge steht verschlüsselt in den Metadaten der Datei und dient beim Download dazu, die Füllbytes wieder zu entfernen. Bei großen Dateien wird nur der letzte Block aufgefüllt, alle anderen sind volle 10 MB groß.
Die Metadaten der Datei enthalten drei Felder, die diesen Aufbau beschreiben: die Basis-Nonce, die Blockgröße und ein Kennzeichen, dass der Index authentifiziert ist. Alle Komponenten, die Dateien lesen (Web-App, Desktop-Sync-Client, macOS-Client und der Service Worker für Downloads), werten diese Felder aus und entschlüsseln entsprechend. Dateien aus der Zeit vor dem einheitlichen Format, die als ein einziger verschlüsselter Block abgelegt wurden, bleiben über einen Altpfad dauerhaft lesbar. Geändert hat sich nur, wie neue Uploads aussehen.
Hochladen: einen Block verschlüsseln, senden, vergessen
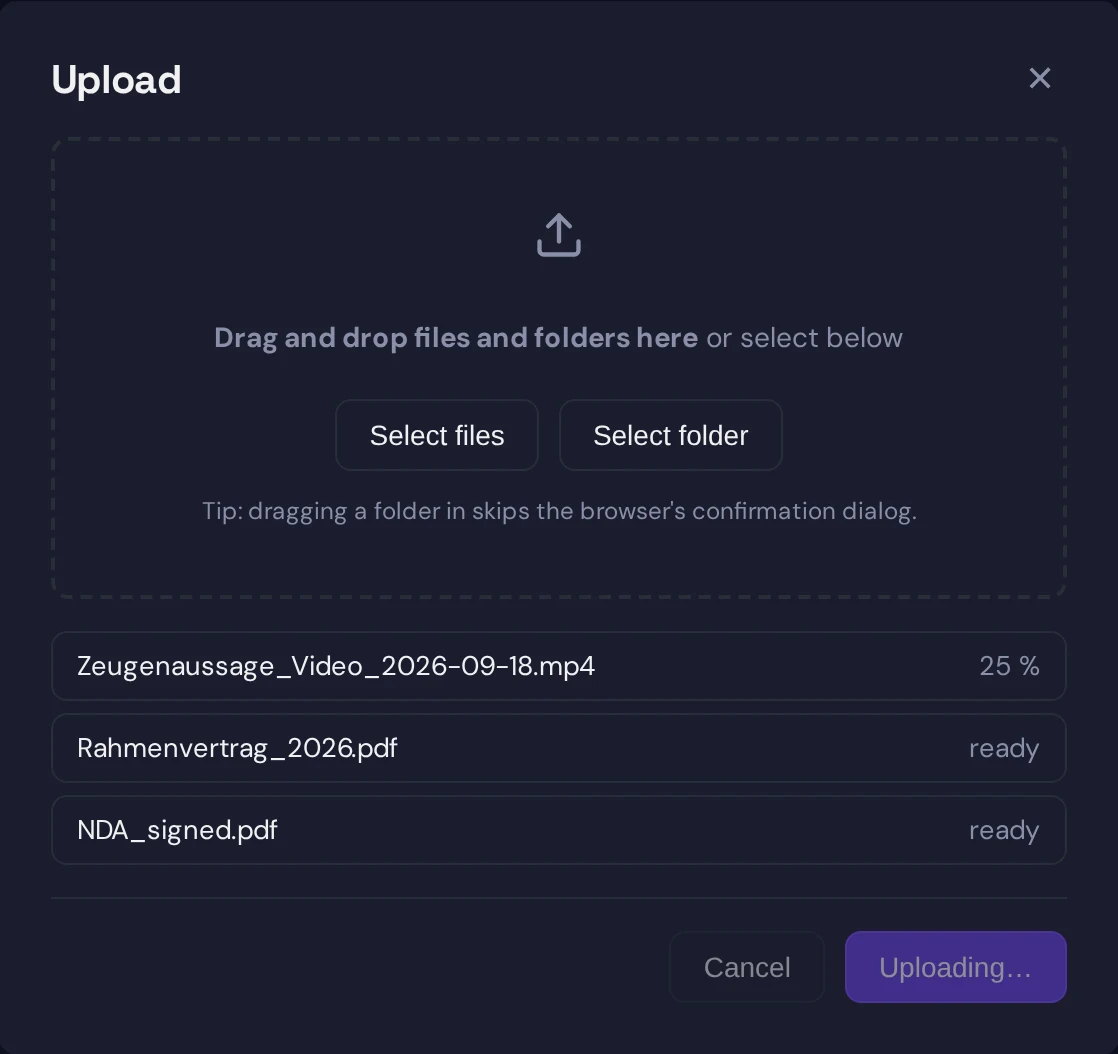
Der Browser hält zu keinem Zeitpunkt mehr als etwa einen Klartextblock und einen Chiffratblock im Arbeitsspeicher. Er nimmt einen 10-MB-Ausschnitt der Quelldatei, den der Browser als Sicht und nicht als Kopie bereitstellt, füllt ihn auf, falls es der letzte ist, verschlüsselt ihn, sendet ihn und überlässt ihn der Speicherbereinigung. Ein Upload von 20 GB braucht etwa so viel Arbeitsspeicher wie einer von 20 MB. Der Spitzenbedarf wächst nicht mit der Dateigröße, und genau diese Eigenschaft macht die Verschlüsselung großer Dateien im Browser überhaupt erst möglich.
Unterhalb einer Schwelle von 5 MB werden die Blöcke aneinandergehängt und in einer einzigen Anfrage gesendet, weil sich eine eigene Anfrage pro Block bei kleinen Dateien nicht lohnt. Darüber eröffnet der Client eine Upload-Sitzung beim Backend, sendet jeden verschlüsselten Block als eigene Anfrage und schließt die Sitzung, sobald der letzte bestätigt ist. Das Backend reicht jeden Block direkt als einen Teil eines S3-Multipart-Uploads an den Objektspeicher weiter, ohne ihn auf die Festplatte zu schreiben oder die ganze Datei zu puffern. Schließt der Client die Sitzung ab, lässt das Backend den Objektspeicher die Teile in der richtigen Reihenfolge zusammensetzen, legt die Datei an, prüft das Speicherkontingent des Owners gegen die endgültige Größe und schreibt den Audit-Eintrag.
Drei Details sorgen dafür, dass das auch bei schlechter Verbindung zuverlässig funktioniert. Ein Block, dessen Übertragung fehlschlägt, wird bis zu dreimal mit kurzer Wartezeit erneut gesendet, bevor der Upload als gescheitert gilt. Eine Sitzung, und mit ihr das unvollständige Objekt im Objektspeicher, wird verworfen, wenn sie nicht innerhalb von 24 Stunden abgeschlossen ist. Ein Browser, der mitten im Upload geschlossen wurde, hinterlässt also nichts. Und die Blockgröße begrenzt, was eine einzelne Anfrage transportieren kann. Deshalb kann der Reverse Proxy eine Anfragegrenze von rund 110 MB durchsetzen, ohne einer Datei von mehreren Gigabyte je im Weg zu stehen.
Eine Prüfsumme des Klartexts, SHA-256, wird in einem eigenen Durchlauf streamend berechnet und verschlüsselt unter dem Dateischlüssel gespeichert. Mit ihr können Sie nach einem Download die Unversehrtheit der Datei prüfen, und der Sync-Client erkennt damit nach einem Schlüsselwechsel unveränderten Inhalt. Sie wird verschlüsselt gespeichert, weil ein Hash im Klartext ein Fingerabdruck wäre: Mit ihm könnte der Server prüfen, ob ein bestimmtes, ihm bekanntes Dokument in Ihrem Vault liegt. Genau dieses Wissen verwehrt ihm das Konzept.
Was der Server sieht
Eine Upload-Sitzung, eine Folge unlesbarer 10-MB-Teile, einen Abschlussaufruf. Die Größe, den Owner, den Ordner, den maskierten Dateinamen und die versiegelten Metadaten. Nicht den Schlüssel, nicht den Inhalt, nicht den echten Namen. Bei einem großen Upload hat das Backend genau eine Aufgabe: Nur es spricht mit den Zugangsdaten zum Objektspeicher. So gelangen diese Zugangsdaten nie in den Browser, und es muss kein Cross-Origin-Upload (CORS) in einen Bucket konfiguriert werden. Diesen Weg haben wir bewusst gegenüber vorsignierten URLs gewählt. Das kostet das Backend Bandbreite, erspart aber eine ganze Klasse von Konfigurationsfehlern.
Herunterladen: drei Wege auf die Festplatte
Eine große Datei herunterzuladen ist schwieriger als sie hochzuladen, denn der normale Download-Mechanismus des Browsers erwartet eine URL, die er direkt abrufen kann, und unter der URL liegt Chiffrat. Sapherbox kennt drei Verfahren und probiert sie der Reihe nach durch.
Das erste ist ein Service Worker. Klicken Sie bei einer großen Datei auf „Herunterladen“, übergibt die Seite den Dateischlüssel und ein Einmal-Token an einen Service Worker im Hintergrund und ruft dann eine Download-Adresse auf, die nur dieser Worker beantwortet. Der Worker holt das Chiffrat vom Backend, entschlüsselt es Block für Block, während die Bytes eintreffen, und streamt den Klartext in den normalen Download des Browsers. Der Speicherbedarf bleibt bei etwa zwei Blöcken, die Datei landet mit der gewohnten Fortschrittsanzeige im Download-Ordner, und Sie können weiternavigieren oder den Tab schließen. Ab diesem Punkt gehört die Übertragung dem Browser. Der Schlüssel verlässt den Browserprozess nie.
Das zweite Verfahren, für Browser ohne nutzbaren Service Worker, ist die File System Access API: Sie werden zuerst gefragt, wo die Datei gespeichert werden soll, und der entschlüsselte Strom wird dorthin geschrieben, während er entsteht, wieder bei konstantem Speicherbedarf.
Das dritte Verfahren, für Browser, die keines von beiden unterstützen, entschlüsselt in der Seite mit derselben streamenden Transformation, zeigt eine Fortschrittsanzeige mit einer Schaltfläche zum Abbrechen und löst den Download aus, sobald der Strom vollständig ist. Dieser Weg muss das Ergebnis bis zum Ende vorhalten, deshalb kommt er zuletzt.
Auf der Serverseite reicht der Download-Endpunkt das Objekt ohne Pufferung durch, mit Zeitlimits, die auch für eine sehr große Datei über eine langsame Verbindung reichen. Unterhalb von 100 MB kommt keines dieser drei Verfahren zum Einsatz. Die Datei wird im Arbeitsspeicher entschlüsselt und dann gespeichert, denn bei dieser Größe wären Speicherdialog und Fortschrittsanzeige lästiger als eine Sekunde Wartezeit.
Wo das Konzept an seine Grenzen stößt
Die Inhaltsbereinigung (CDR), also das Entschärfen von Office-Dokumenten und PDFs beim Hoch- und Herunterladen, braucht den gesamten Klartext auf einmal. Sie gilt deshalb bis zu einer pro Tenant festgelegten Größengrenze und wird darüber übersprungen. Eine große Datei wird genauso verschlüsselt und gespeichert wie eine kleine, aber nicht vorher Seite für Seite neu aufgebaut. Die Grenze ist in den Einstellungen sichtbar, und der Prüfstatus der Datei („Prüfung“) zeigt, ob sie bereinigt wurde.
Die Klassifizierung liest bei textbasierten Dateien das erste halbe Megabyte. Sie sieht also den Anfang einer großen CSV- oder Logdatei und nichts danach. Was sie erkennt und was nicht, haben wir beschrieben.
Und ein Upload lässt sich nach einem Browser-Neustart nicht fortsetzen. Wird der Tab bei 60 Prozent geschlossen, wird die Sitzung verworfen, und der Upload beginnt von vorn. Der Sync-Client, der seinen Zustand auf der Festplatte halten kann, ist für sehr große oder sehr viele Dateien das bessere Werkzeug. Er nutzt dasselbe Blockformat, dasselbe Sitzungsprotokoll und dieselben 10 MB Blockgröße. Eine vom Client und eine vom Browser hochgeladene Datei sind im Objektspeicher nicht zu unterscheiden.
Warum diese Form
Wir hätten es uns bei großen Dateien leichter machen können. Ließe man den Server verschlüsseln, fiele jede Arbeitsspeicherbeschränkung im Browser weg. Ein direkter Upload in den Bucket über eine vorsignierte URL nähme das Backend aus dem Datenpfad. Eine Prüfsumme im Klartext machte Deduplizierung trivial. Jede dieser Entscheidungen ist üblich, und jede gibt dem Server etwas, das er nach dem Konzept nicht haben darf: den Schlüssel, die Speicher-Zugangsdaten im Browser oder einen Fingerabdruck Ihrer Inhalte.
Das Blockformat ist das, was übrig bleibt, wenn man diese Optionen ausschließt. Es hält den Arbeitsspeicherbedarf konstant, es authentifiziert jedes Byte einschließlich seiner Position, es funktioniert durch einen Reverse Proxy mit gewöhnlichen Anfragegrenzen, und es erlaubt einem Service Worker, aus einem entschlüsselnden Strom einen normalen Browser-Download zu machen.
Fragen?
Wenn Sie regelmäßig große Dateien bewegen, das Blockformat für eine Integration spezifiziert haben möchten oder wissen wollen, wie sich der Sync-Client mit einem Ordner von mehreren Terabyte verhält, schreiben Sie uns an hello@sapherbox.com.