
Automatische Klassifizierung: Warum die DSGVO-Konformität davon abhängt
Was Sie nicht finden, können Sie weder schützen noch melden noch löschen. So klassifiziert Sapherbox Dokumente auf Ihrem Gerät vor der Verschlüsselung, und was Ihnen das für die DSGVO bringt.
Die meisten Pflichten aus der DSGVO setzen stillschweigend etwas voraus: Sie müssen wissen, wo die personenbezogenen Daten liegen. Das Verzeichnis von Verarbeitungstätigkeiten geht davon aus, dass Sie diese Daten auflisten können. Ein Auskunftsersuchen geht davon aus, dass Sie die Daten einer Person innerhalb eines Monats finden. Die Meldung einer Datenpanne binnen 72 Stunden geht davon aus, dass Sie sagen können, was im betroffenen System lag. Und die Speicherbegrenzung geht davon aus, dass Sie wissen, welche Daten ihren Zweck erfüllt haben.
Auf einer Dokumentenplattform ist nichts davon selbstverständlich. Personenbezogene Daten kommen nicht mit Etikett. Sie kommen als CSV-Export, den jemand in einen Projektordner gelegt hat, als Support-Protokoll mit E-Mail-Adressen von Kunden, als Vertrag mit einem Geburtsdatum auf Seite vier. Verschlüsselung ist die richtige Antwort auf die Frage der Vertraulichkeit. Sie macht dieses Problem aber schwieriger. Ein Server, der Dokumente nicht lesen kann, kann sie auch nicht für Sie durchsuchen.
Dieser Artikel erklärt, wie Sapherbox damit umgeht. Und er begründet, warum aus unserer Sicht nur eine Klassifizierung beim Upload, auf Ihrem Gerät, zu einem Ende-zu-Ende-verschlüsselten Produkt passt.
Was die Klassifizierung tut
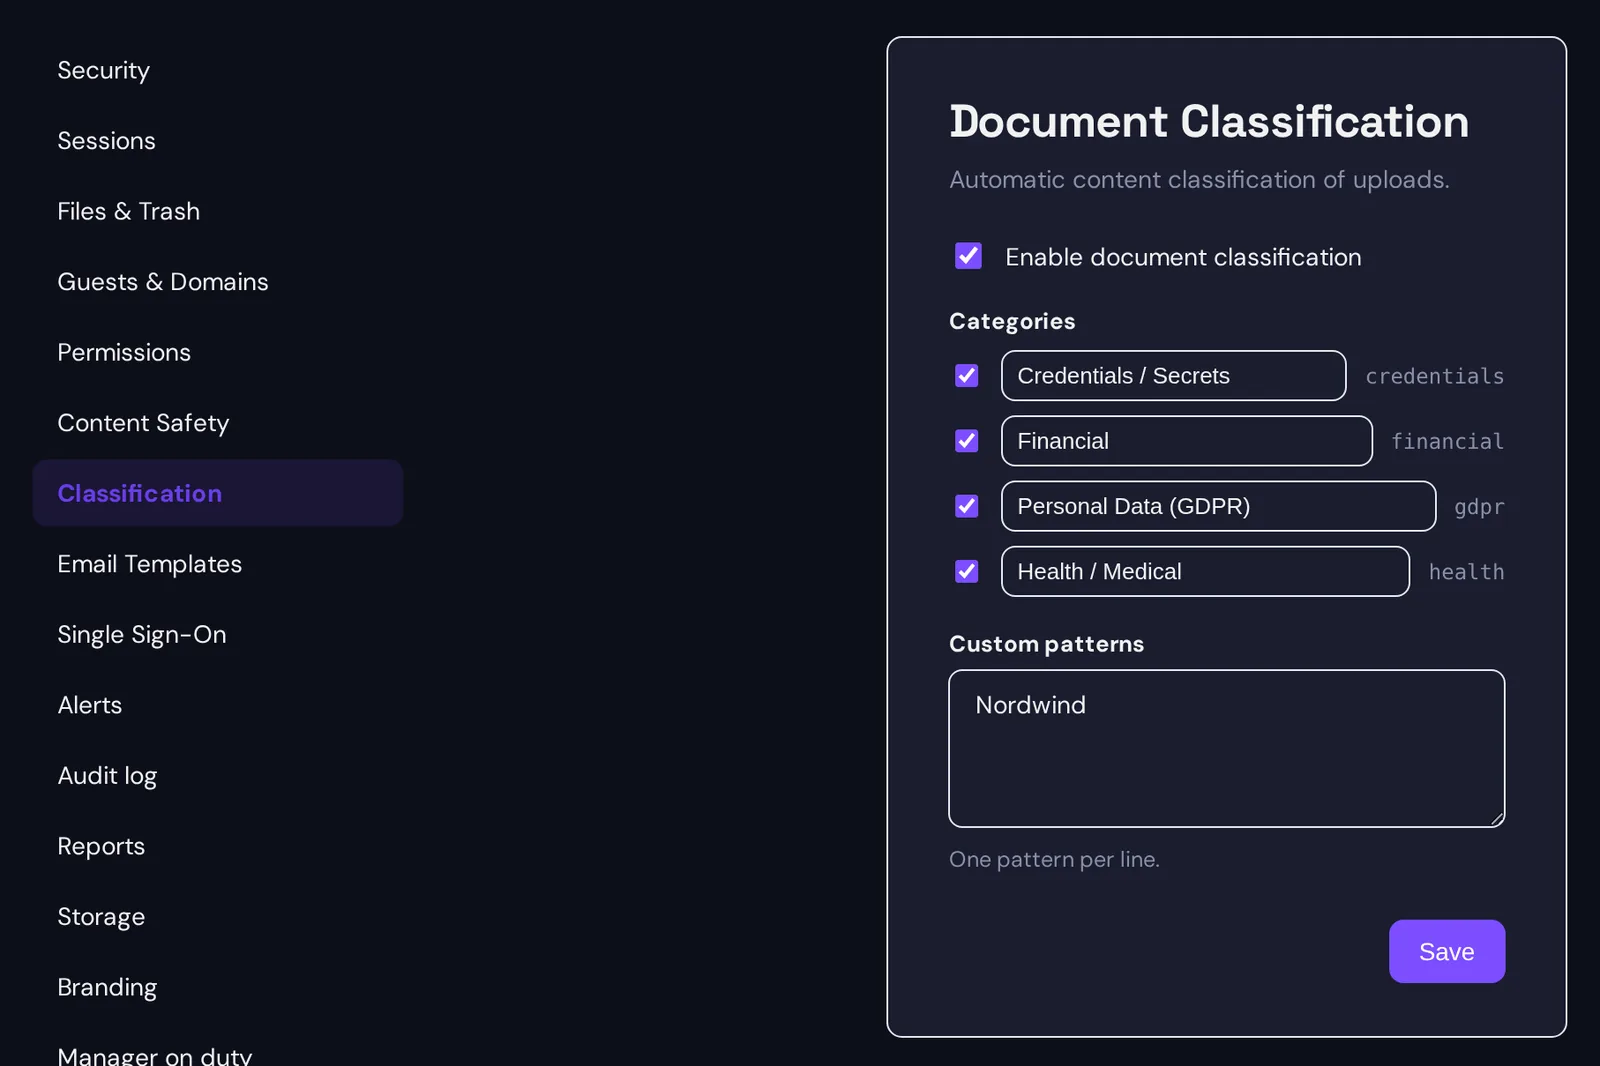
Ist die Klassifizierung für Ihren Tenant aktiviert, prüft der Browser beim Upload jede textbasierte Datei. Das geschieht nach einer etwaigen Inhaltsbereinigung und vor der Verschlüsselung. Der Scanner sucht nach Merkmalen aus vier Kategorien, mit Mustern für englische und deutsche Dokumente:
- Personenbezogene Daten. E-Mail-Adressen, Telefonnummern, nationale Identifikationsnummern, Geburtsdaten und die Feldbezeichnungen, die meist daneben stehen: Name, Anschrift, Geburtsdatum, Reisepass- oder Ausweisnummer, Versicherungsnummer und Ähnliches.
- Finanzdaten. Kartennummern, IBANs, Bankverbindungen und Begriffe wie Gehalt, Einkommen oder Kontostand.
- Gesundheitsdaten. Diagnose, Rezept, Arztbericht, Laborbefund und verbreitete Krankheitsbezeichnungen. Diese Kategorie ist standardmäßig ausgeschaltet. Gesundheitsdaten gehören zu den besonderen Kategorien personenbezogener Daten nach Artikel 9 DSGVO. Ob sie erkannt werden, sollte Ihr Datenschutzbeauftragter bewusst entscheiden.
- Zugangsdaten. Passwörter, API-Schlüssel und Tokens, die in einem geteilten Ordner überhaupt nichts zu suchen haben.
Ihr Administrator kann eigene Muster ergänzen, zum Beispiel das Format Ihrer Kundennummern oder ein Projekt-Codewort. Jede erkannte Kategorie wird als Label an der Datei gespeichert. Der Inhalt, in dem sie gefunden wurde, bleibt verschlüsselt und verlässt den Browser wie immer nur als Chiffrat.
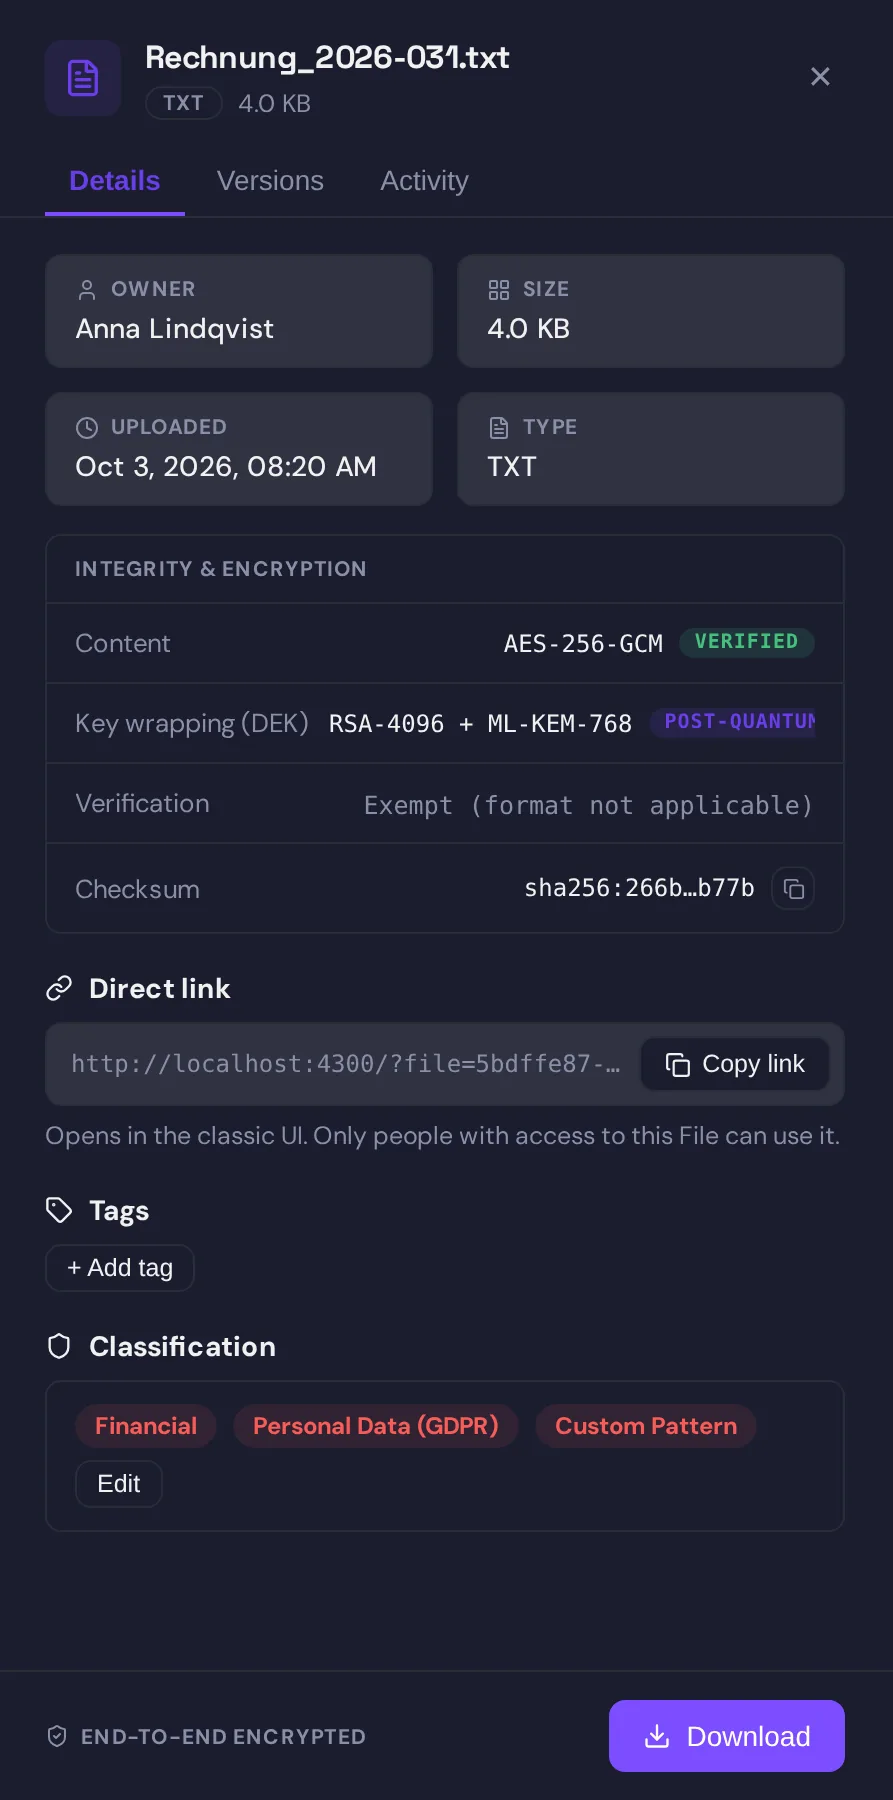
In den Eigenschaften einer Datei sehen Benutzer die erkannten Kategorien und können sie korrigieren. Sie können eine Kategorie ergänzen, die der Scanner übersehen hat, oder einen Fehltreffer entfernen. Solche Korrekturen werden als manuell gesetzt gekennzeichnet, und jede Änderung landet im Audit-Log.
Wo die Labels ihre Wirkung entfalten
Ein Label allein ist nur ein Hinweis. Seinen Wert bekommt es erst durch die Funktionen, die es auswerten.
Der Bericht zum Datenbestand. Mit dem Bericht „Datenbestand“ können Administratoren eine Liste aller Dateien mit ihrer Klassifizierung und einem etwaigen Aufbewahrungs- oder Löschtermin erstellen und als CSV exportieren. Näher an ein Verzeichnis nach Artikel 30 kommt ein Dokumentenspeicher aus eigener Kraft nicht heran. Die Liste zeigt, wo personenbezogene Daten liegen, in welchen Ordnern, wem sie gehören und wann sie gelöscht werden sollen.
Workflows. Eine Klassifizierung kann einen Workflow auslösen. Ein Tenant kann zum Beispiel festlegen, dass das Compliance-Team eine Warnung bekommt, wenn eine als Gesundheitsdaten klassifizierte Datei in einem Ordner liegt, der mit externen Gästen geteilt ist. Er kann festlegen, dass eine Datei, auf die ein eigenes Muster passt, in einen gesperrten Ordner verschoben wird. Oder dass Zugangsdaten in einem Upload ein Ticket erzeugen. Die Regeln arbeiten mit Labels, nicht mit Inhalten. Niemand muss dafür das Dokument lesen, auch die Automatisierung nicht.
Aufbewahrung. Ordner können ein Ablaufdatum haben, an dem ihr Inhalt automatisch gelöscht wird. Zusammen mit dem Datenbestand wird die Speicherbegrenzung so zu einem Zeitplan statt zu einem Vorsatz.
Zugriffsprüfungen. Die Administratorberichte darüber, wer worauf Zugriff hat, lassen sich mit den Klassifizierungslabels abgleichen. Die Frage „Wer kann Gesundheitsdaten sehen?“ ist dann ein Filter und kein Projekt.
Warum auf dem Gerät und vor der Verschlüsselung
Naheliegend wäre es, den Scanner nach dem Upload auf dem Server laufen zu lassen, wo er alles sieht. Für Sapherbox kommt das nicht infrage. Und unserer Meinung nach sollte es für kein Produkt infrage kommen, das Ende-zu-Ende-Verschlüsselung verspricht.
Läuft die Klassifizierung im Browser, verlässt der Klartext das Gerät nie zu Analysezwecken. Der Server bekommt das Label und das Chiffrat, sonst nichts. Außerdem ist der Kompromiss damit offen benannt. Das Label gehört zu den wenigen Dingen, die der Server über ein Dokument sehen kann, neben Größe, Zeitstempeln und der Liste der Zugriffsberechtigten. Das steht auch so in unserer Sicherheitsübersicht. Wer im Rahmen einer Prüfung fragt, was der Anbieter durch die Klassifizierung erfährt, bekommt eine Antwort in einem Satz: die Namen der Kategorien, sonst nichts.
Es gibt einen zweiten Grund. Ein Scanner, der vor der Verschlüsselung läuft, läuft auch, bevor die Daten irgendwo abgelegt sind. Eine Kartennummer oder ein Passwort, das beim Upload auffällt, kann abgewiesen, markiert oder verschoben werden, bevor es in einem Ordner liegt, den vierzig Personen öffnen können.
Was die Klassifizierung nicht leistet
Klassifizierung ist Mustererkennung, und Mustererkennung hat Grenzen. Sie sollen diese Grenzen lieber hier erfahren als bei einem Audit.
- Nur Textformate. Der Scanner liest reinen Text, CSV, JSON, Markdown, Logs, Konfigurations- und Quelltextdateien, jeweils das erste halbe Megabyte. PDFs und Office-Dokumente öffnet er nicht, und Bilder liest er nicht. Ein eingescannter Vertrag bleibt für ihn unsichtbar. Wo sensible Daten vor allem in Office-Dateien liegen, kommt es stärker auf manuell gesetzte Labels an, denn eigene Muster laufen im selben Scanner und erreichen diese Dateien ebenfalls nicht. Die Lücke steht auf unserer Liste.
- Falsch-negative Treffer kommen vor. Ein Muster für IBANs erkennt keine Bankverbindung, die als Fließtext ausgeschrieben ist. Ein falsch-negatives Ergebnis heißt: Die Datei bekommt kein Label, und kein Workflow wird ausgelöst. Die Klassifizierung grenzt die Suche ein. Sie ersetzt keine verantwortliche Person, die weiß, wofür ein Ordner da ist.
- Falsch-positive Treffer ebenso. Eine Telefonnummer in der Signatur eines Lieferanten macht aus einer Rechnung „personenbezogene Daten“. Nach der DSGVO stimmt das meist sogar, und genau darum geht es. Es bedeutet aber, dass die Labels beschreiben, ob etwas vorkommt, und nicht, wie sensibel es ist.
- Der Server sieht die Labels. Das ist so gewollt, damit Berichte und Workflows funktionieren. Wenn in Ihrem Tenant bereits die Tatsache, dass ein Ordner Gesundheitsdaten enthält, vor dem Betreiber verborgen bleiben muss, lassen Sie diese Kategorie ausgeschaltet. Verwenden Sie stattdessen eigene Muster mit neutralen Namen wie „öffentlich“, „nur intern“, „vertraulich“ und „geheim“. Der Server sieht dann eine Vertraulichkeitsstufe, aber nicht, um welche Art von Daten es sich handelt.
- Dateien, die vor dem Aktivieren der Klassifizierung hochgeladen wurden, haben kein Label, bis sie erneut hochgeladen oder von Hand klassifiziert werden.
Wie sich das auf die DSGVO abbilden lässt
Für alle, die sich mit Compliance befassen, hier die Bezüge im Überblick:
- Artikel 30, Verzeichnis von Verarbeitungstätigkeiten. Der Datenbestand zeigt Ort, Kategorie und Aufbewahrung personenbezogener Daten innerhalb der Plattform und lässt sich jederzeit exportieren.
- Artikel 32, Sicherheit der Verarbeitung. Warnungen und automatisches Verschieben, ausgelöst durch die Klassifizierung, sind technische Maßnahmen, die an der Sensibilität ansetzen. Sie werden protokolliert.
- Artikel 5 Abs. 1 lit. e, Speicherbegrenzung. Ablaufdaten für Ordner und die Aufbewahrungsspalte im Datenbestand machen aus einem Grundsatz konkrete Termine.
- Artikel 15, Auskunftsrecht der betroffenen Person. Zusammen mit der Suche grenzen Labels ein, wo Sie innerhalb der Frist nach den Daten einer Person suchen müssen.
- Artikel 33 und 34, Meldung von Datenpannen. Wird ein Konto oder eine Freigabe kompromittiert, zeigt Ihnen der Datenbestand binnen Minuten, ob personenbezogene Daten oder Daten besonderer Kategorien betroffen waren. Davon hängt ab, ob Sie melden müssen und wen Sie benachrichtigen müssen.
- Artikel 9, besondere Kategorien. Die Erkennung von Gesundheitsdaten muss eigens eingeschaltet werden. Ob sie stattfindet, ist damit eine dokumentierte Entscheidung und keine Voreinstellung.
Nichts davon macht einen Tenant für sich genommen konform. Es gibt aber den Personen, die für die Compliance zuständig sind, genau das, was ihnen ein verschlüsselter Speicher sonst vorenthält: eine Landkarte.
Fragen?
Wenn Sie besprechen möchten, wie die Klassifizierung zu Ihrem Verzeichnis von Verarbeitungstätigkeiten passt, oder Ihr Datenschutzbeauftragter die Erkennungsregeln und das Berichtsformat sehen möchte, schreiben Sie uns an hello@sapherbox.com.