
Verschlüsselte Dokumente durchsuchen: der Blind-Index
Volltextsuche in Dateien, die der Server nicht lesen kann? Wie Sapherbox das löst, was der Server dabei trotzdem erfährt und wo die Suche an ihre Grenzen stößt.
Wenn der Server Ihre Dateien nicht lesen kann, wie soll er sie dann durchsuchen? Bei den meisten Ende-zu-Ende-verschlüsselten Speicherdiensten lautet die ehrliche Antwort: gar nicht. Bestenfalls lassen sich Dateinamen durchsuchen, der Inhalt der Dokumente bleibt außen vor. Sapherbox durchsucht Namen und Inhalte. Dieser Artikel erklärt, wie das gelingt, ohne dass der Server die Wörter erfährt. Und er erklärt, was der Server dabei doch erfährt, denn das ist genauso wichtig.
Suchen heißt abgleichen
Im Kern ist Suche eine einfache Aufgabe. Sie geben ein Wort ein, und gesucht sind die Dokumente, die es enthalten. Eine herkömmliche Suchmaschine legt dafür einen Index an, eine große Tabelle nach dem Muster „Wort → Liste von Dokumenten“, und schlägt Ihr Wort darin nach. Dieser Index ist nichts anderes als der Klartext aller Dokumente, nur anders sortiert. Läge er beim Server, wäre die Verschlüsselung wertlos.
Der Kniff besteht darin, dieselbe Tabelle zu bauen und jedes Wort durch eine getarnte Fassung zu ersetzen. Der Server kann die Tarnung nicht rückgängig machen, Ihr Gerät kann sie jederzeit wieder erzeugen. Wird aus „Rechnung“ immer dasselbe unlesbare Token, kann der Server weiterhin Tokens miteinander abgleichen. Er weiß nur nicht, welches Wort hinter einem Token steht. In der Kryptografie heißt das Blind-Index.
Wie aus einem Wort ein Token wird
Jede Person hat einen geheimen Suchschlüssel. Das sind 256 Zufallsbits, die der Browser bei der ersten Nutzung erzeugt. Der Suchschlüssel liegt auf dem Server und ist für Ihre eigenen Schlüssel versiegelt, mit derselben hybriden Schlüsselverpackung, die auch Ihre Dateien schützt. Der Server speichert ihn also, kann ihn aber nicht öffnen.
Wenn Sie ein Dokument hochladen, erledigt Ihr Browser die Arbeit:
- Er extrahiert den Text. Bei PDFs, Word-, PowerPoint- und OpenDocument-Dateien sowie bei reinen Textformaten geschieht das auf Ihrem Gerät, und zwar nach einer etwaigen Inhaltsbereinigung und vor der Verschlüsselung.
- Er zerlegt den Text in Wörter und schreibt sie klein. Wörter mit weniger als drei Zeichen, kurze Zahlen und eine Handvoll englischer Stoppwörter wie „the“ und „and“ fallen weg, ebenso doppelte Einträge. Der Dateiname durchläuft dieselben Regeln, getrennt vom Inhalt.
- Jedes verbleibende Wort durchläuft HMAC-SHA-256 mit Ihrem Suchschlüssel. HMAC ist eine Einwegfunktion mit Schlüssel. Dasselbe Wort ergibt mit demselben Schlüssel immer dieselbe Ausgabe. Ohne den Schlüssel verrät die Ausgabe nichts über das Wort. Die ersten 16 Bytes jeder Ausgabe bilden das Token.
- Die Tokens, und nur sie, gehen an den Server. Er speichert sie zusammen mit der Kennung der Datei und markiert jedes als Namens- oder Inhaltstoken.
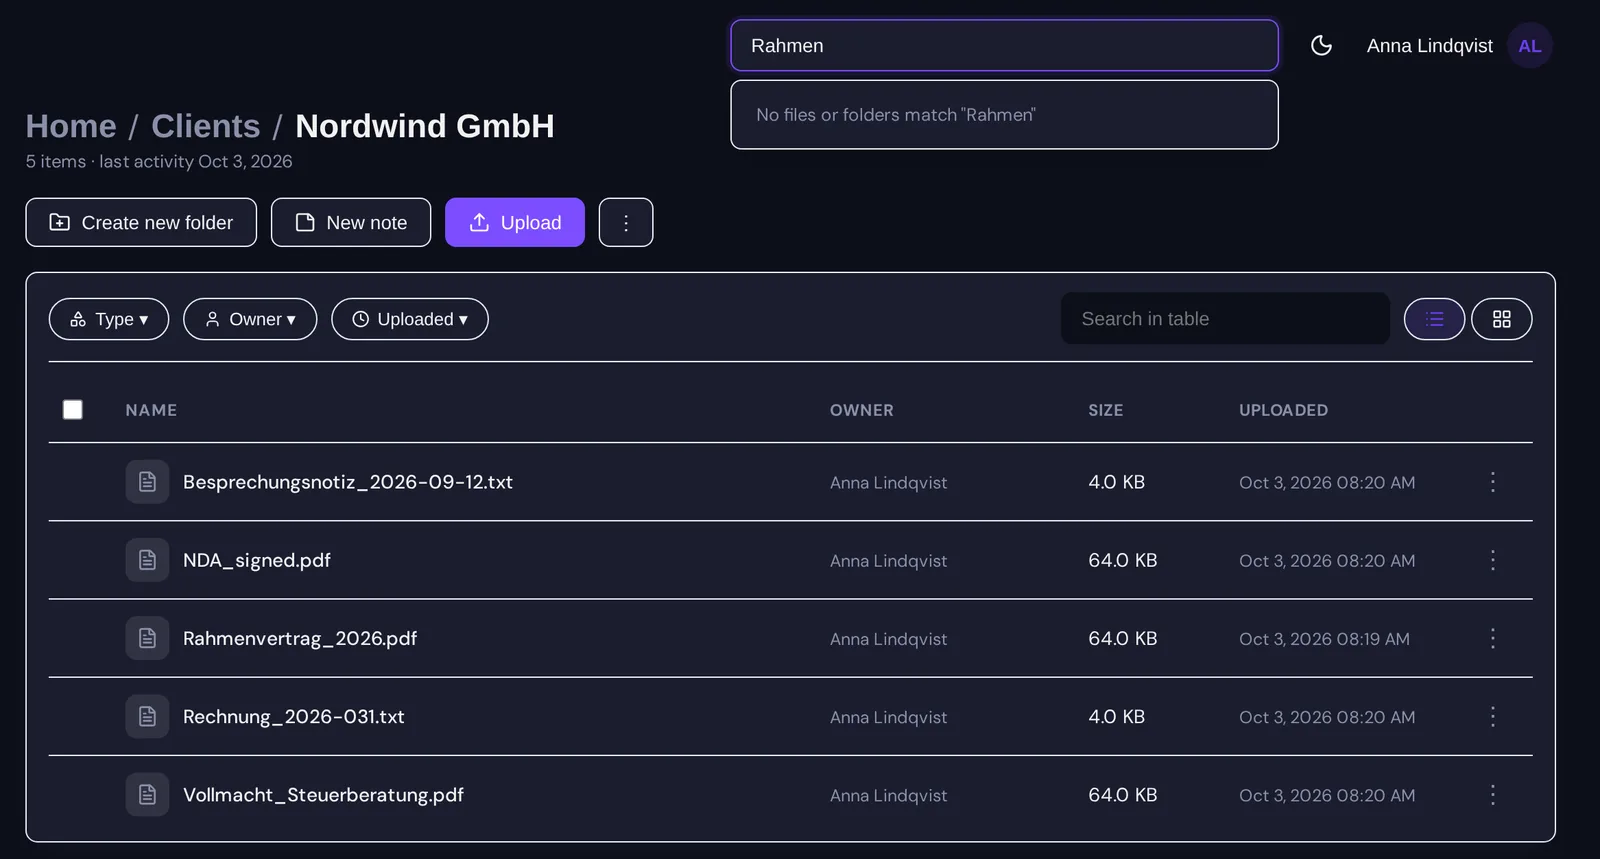
Wenn Sie suchen, wendet Ihr Browser dieselben Regeln auf Ihre Eingabe an, berechnet mit demselben Schlüssel dieselben Tokens und schickt sie ab. Der Server liefert jede Datei, zu der eines dieser Tokens gespeichert ist. Ihr Browser entschlüsselt die Dateinamen für die Anzeige. Kein einziges Wort hat dabei Ihr Gerät im Klartext verlassen.
Die Tokens hängen von Ihrem Schlüssel ab. Dasselbe Wort ergibt deshalb im Index zweier Personen zwei Tokens, die nichts miteinander zu tun haben. Der Server kann nicht einmal erkennen, dass die Dokumente zweier Personen ein gemeinsames Wort enthalten.
Was der Server trotzdem erfährt
Genau danach fragt jeder sorgfältige Prüfer. Die Antwort lautet nicht „nichts“.
Wie viele verschiedene Wörter eine Datei enthält. Eine Datei mit 40 Tokens ist eine kurze Notiz, eine mit 4.000 Tokens ein langer Bericht. Die Länge war ohnehin schon an der Größe des Chiffrats abzulesen. Viel Neues erfährt der Server dadurch nicht.
Welche Dateien gemeinsame Wörter haben. In Ihrem eigenen Index wird „Rechnung“ in jeder Datei zum selben Token. Der Server sieht, dass die Dateien A, B und C ein Token gemeinsam haben, weiß aber nicht, für welches Wort es steht. Mit der Zeit und mit Wissen von außen können solche Muster Hinweise auf den Inhalt geben. Ein Token, das in fast jeder Datei vorkommt, ist vermutlich Ihr Firmenname. Das ist der bekannte Preis jeder durchsuchbaren Verschlüsselung, die schnell genug für den Alltag ist. Die Fachliteratur ist da eindeutig: Häufigkeiten und gemeinsames Auftreten von Wörtern sickern durch. Wir behaupten nichts anderes.
Wonach Sie suchen, in verblindeter Form. Der Server sieht, welche Tokens Sie abgefragt haben und welche Dateien er zurückgegeben hat. Er weiß also, dass Sie nach etwas gesucht haben und was gefunden wurde. Was dieses Etwas ist, weiß er nicht.
Nichts von Gästen, kein Abgleich zwischen Personen. Jede Person hat ihren eigenen Schlüssel. Es gibt also keinen Index, den der Server über Konten hinweg vergleichen könnte. Wer später Zugriff auf eine Datei bekommt, übernimmt auch nicht automatisch die Tokens der Person, die sie hochgeladen hat.
Die meisten Produkte gehen einen anderen Weg. Sie entschlüsseln auf dem Server und bauen dort einen gewöhnlichen Index. Der Unterschied zu unserem Ansatz ist der zwischen einem Umriss und dem Text selbst.
Wo die Grenzen liegen
Der Blind-Index hat Grenzen, die sich aus seiner Bauart ergeben. Wir nennen sie lieber selbst, bevor Sie darauf stoßen.
- Nur ganze Wörter. Ein Token steht für ein vollständiges Wort. „Rechnungen“ und „Rechnung“ ergeben deshalb verschiedene Tokens, und eine Suche nach „Rech“ findet nichts. Für eine Präfixsuche müssten wir zu jedem Wort Tokens für alle seine Wortanfänge speichern. Das würde den Index vervielfachen und mehr preisgeben. Darauf haben wir bewusst verzichtet.
- Ihr Index enthält nur, was Sie indexiert haben. Tokens entstehen unter Ihrem Schlüssel, wenn Sie etwas hochladen, anlegen oder umbenennen. Ein Dokument, das eine Kollegin mit Ihnen geteilt hat, kommt erst dann in Ihren Index, wenn Sie es selbst hochladen, anlegen oder umbenennen. Dateien, die über einen anonymen Upload-Link eingehen, werden gar nicht indexiert, denn wer sie hochgeladen hat, hatte Ihren Schlüssel nie.
- Gescannte PDFs sind Bilder. Ohne Text gibt es keine Tokens. Texterkennung (OCR) auf dem Gerät würde das ändern. Sie ist ein Kandidat für denselben Ansatz, den wir schon für Zusammenfassungen und Übersetzungen nutzen: direkt auf dem Gerät.
Warum dieser Kompromiss
Wir könnten auf die Inhaltssuche verzichten und gar nichts preisgeben. Oder wir könnten auf dem Server suchen und alles preisgeben. Der Blind-Index liegt dazwischen. Sie bekommen die Suche, die Menschen tatsächlich nutzen. Der Server bekommt den Umriss Ihres Wortschatzes, nicht den Wortschatz selbst. Für eine Organisation, deren Bedrohungsmodell lautet „Der Anbieter darf unsere Dokumente nicht lesen können“, ist das der richtige Kompromiss. Auf ihn läuft am Ende jedes ernstzunehmende verschlüsselte Produkt mit Suchfunktion hinaus.
Entscheidend ist, dass dieser Umriss dokumentiert ist. Der Sicherheitsüberblick führt verblindete Suchtokens ausdrücklich unter den Daten auf, die unsere Server sehen können. Dieser Artikel ist die ausführliche Fassung dieser einen Zeile.
Fragen?
Möchten Sie besprechen, ob das, was die Suche preisgibt, zu Ihrem Bedrohungsmodell passt? Oder braucht Ihr Sicherheitsteam die genauen Regeln der Tokenisierung und das Indexschema? Dann schreiben Sie uns an hello@sapherbox.com.